
跟着大模子与Agent走向限度化落地,AI基础智力的要点渐渐转换。
昔日几年里,业界的眼神险些全放在了算力上,可当算力集群的限度从千卡走向万卡乃至十万卡,一个个荫藏的瓶颈初始透露。
在素养场景中,大模子参数从千亿级迈向十万亿级,通讯时延、收集拥塞等问题,严重牵涉有用算力运用率;在推理场景中,陡立文序列扩张至百万级,KV Cache限度快速增长,内存和存储的带宽、容量与掷中率,平直影响推理费解量和首Token延长。
行业需要的不仅仅更强的CPU、GPU/NPU,收集、存储、DPU等蓄意模组需要同步升级。怎么知足不同场景下的性能需求,同期适配客户既有的期间阶梯,成了必须恢复的新问题。
华为蓄意模组给出的谜底是——提供高可靠的硬件产物与全链路期间支捏,和伙伴、成就者一齐共筑产业生态。
一方面以怒放兼容激活生态活力,华为蓄意模组全面支捏ARM/x86架构,兼容openEuler、Ubuntu等主流操作系统,不休买通期间适配界限,推动生态共建共荣。
另一方面,咱们坚捏自主编削,网卡、SSD、DPU、RAID卡等产物的多项要道性能方针业界最初,形成了完满的存储与收集模组产物矩阵,粉饰通算、智算全场景。
尽头是在华为全齐集大会2026上重磅发布的AI网卡和KVU,差异对准了收集通讯与KV Cache瓶颈。
以网强算:为蓄意集群修一条“高速公路”在不少东说念主的知道里,收集被视为蓄意集群的配套,只消带宽数字匹配即可。期间来到2026年,传统逻辑被透顶颠覆。
现时沿大模子的参数目攀升至10万亿量级,素养序列迈入百万级,节点与节点之间需要经常同步海量梯度与中间参数。关连掂量标明,在大限度散布式素养中,收集通讯耗时占比照旧达到30-50%。
同期Agent、长文本、多模态的普及,让收集流量结构发生了质变:推理任务重的齐集通讯占比高达30%以上。由于长尾效应,哪怕是收集通讯的轻浅抖动,用户感知到的王人可能是“严重卡顿”。
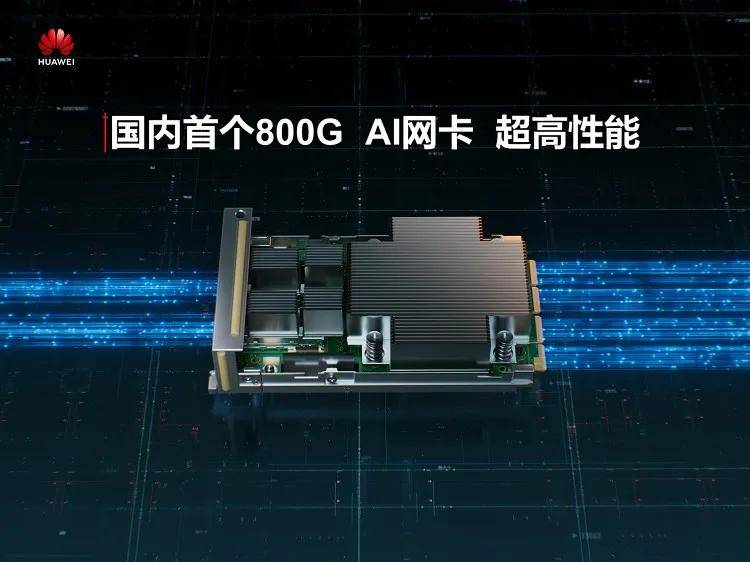
面临日益突显的收集通讯瓶颈,算作国内首发的800G AI网卡,SP560系列在上万个蓄意节点间,修了一条承载数据流动的“高速公路”,用硬核期间正面解答了行业最存眷的三说念必答题。
第一说念题:带宽够不够大?
咫尺业界公认的算连比保管在2到2.5之间,网卡带宽需求照旧训诲到800Gbps,展望2028年将摸高到1.6Tbps。
面向超节点Scale-out假想的SP560系列,支捏10万级的RoCE的大限度组网,编削继承灵衢与PCIe双总线架构,总线带宽最大可达1.6Tbps,可匡助客户把收集性能透顶开释出来。
第二说念题:公约够不够生动?
AI收集有着显著的负载特征,即巨额短流与一丝长流交汇并存,可能出现严重的链路攻击,整网运用率不及40%。
为了知足头部客户自界说公约的需求,基于可编程NP架构的SP560系列网卡,支捏客户针对业务自允洽扩张RDMA公约、TCP公约与各样高阶拥塞限度算法,通过网卡硬件端平直纳尾多旅途分发、乱序重排与遴荐性重传,可将总计集群的收集链路运用率拉升至85%以上。
第三说念题:通讯够不够高效?
在传统作事器架构中,网卡和算力的数据传送主要依赖CPU下发限度教唆,形成了巨额总线带宽损耗与交互延长。
SP560系列网卡进行了两个标的的优化:
一个是GPU/NPU直驱与通讯任务编排卸载,买通算力卡平直限度与管制网卡的通路,跳过CPU的二次中转,同期支捏以齐集通讯组的粒度平直概念通讯矩阵并下发报文,大幅的缩小通讯任务退换支出。
另一个是数控分离架构,将限度面流量与数据面流量阻扰,限度面流量上送CPU处理,海量的数据面业务流量则通过灵衢高速总线纵贯GPU/NPU显存,进而收余数据免CPU拷贝,缩小NPU的通讯时延。
若是把算力比作蓄意集群的“腹黑”,收集便是“大动脉”。算力决定上限,收集决定界限。只消把每一张卡竟然“串”起来,AI集群才能从“堆起来”变成“跑起来”,才能支捏起更多、更大、更聪惠的智算集群。
以存代算:给“爆仓”的KV Cache找一个新家管制了“卡间运力”,为大模子素养和推理扫清了收集阻截。念念要进一步训诲算力运用率,必须冲突“存储墙”和“内存墙”。
大模子的推理经过是自记忆的,每生成一个新的Token,王人要把历史KV Cache从显存里搬来搬去。在百万Token陡立文场景下,KV Cache的显存支出常常占到全体的90%以上。
倘若把KV Cache全放在显存里,硬件采购老本与能耗增长,将让贸易化落地星离雨散;倘若把KV Cache下千里到惯例的SSD里,面临无数目并发读取时极易出现部队拥塞,导致推理首Token延长飙升。
蓄意瓶颈的切换,记号着存储扮装的重构:昔日仅仅“数据仓库”,厚爱存放素养数据、模子权重;当今初始平直参与推理经过,通过KV Cache分层、缓存和复用,匡助开释珍视的蓄意资源。
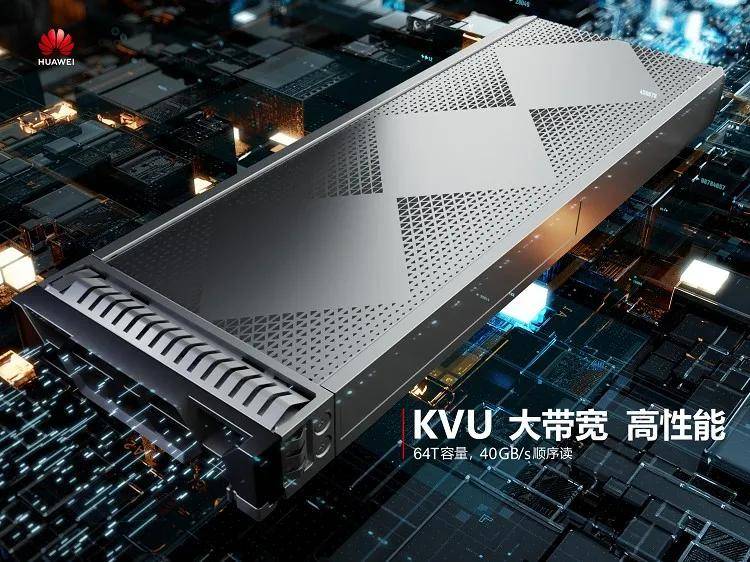
针对传统存储介质无法兼顾容量、时延与带宽的重要,华为蓄意模组推出了专为大模子推理假想的产物——KVU(KV Cache Unit)。
有别于被迫存储的硬盘属性,KVU在模组里面深度集成了蓄意中枢,收尾了腹地数据预处贤达力;依托灵衢互联,KVU单卡最高支捏64TB的海量存储空间、单卡礼貌读带宽达到了40GB/s、礼貌写带宽达到20GB/s、立时读IOPS进步500万。
基于KVU的出色性能,华为蓄意模组围绕“念念作念百万Token长陡立文,却卡在显存不及、老本过高、掷中率低、延长不稳”的落地痛点,打造了兼顾性能与老本的四级KV Cache存储体系。
L1层(HBM):具备TB/s级超高带宽,用于常驻和处理现时正在参与蓄意的最活跃、最高频的热KV数据;
L2层(DDR内存池):具备纳秒级低时延,贯串中小限度并发下的过渡态热KV数据,算作HBM与基层介质之间的弹性缓冲层;
L2.5层(KVU蓄意模组):算作畅达显存与传统闪存之间的中枢锚点,以超高带宽、微秒级读写时延,高效贯串大容量次热与温态KV Cache。
L3层(通用大容量腹地SSD):厚爱限度化永恒留存低频拜谒的冷态KV数据与历史景色日记。
关连测试成果自大:依靠KVU模组自带的算力,巨额前缀查找、缓存校验与形势回荡操作,平直在模组里面并行完成。在本体大模子推理业务中,通过Prefix KV-Cache分级缓存管制机制,NPU运用率训诲了30%,首token时延缩小了50%。
截止到咫尺,KVU决策照旧在多家长文本Agent、多模态推理、企业级智算中心状貌测考考证,大幅缩小了显存占用,竟然收尾了“不堆天价HBM,也能落地超高规格长陡立文AI业务”。
写在终末插足Agentic AI时期,一场深端倪的变革正在献艺。
大模子的参数限度越来越大、Agent任务链越来越长,AI基础智力需要进一步向纵深鼓吹,既要管制核默算力“有莫得”的问题,也要恢复要道模组“强不彊”的问题。
单点堆算力的时期已成昔日开云体育(中国)官方网站,期间编削与生态怒放才是智算时期的输赢手。以自主编削冲突行业瓶颈、以怒放兼容使能产业伙伴、以多元产物知足各异化需求,既是华为蓄意模组交出的工程答卷,亦然AI从参数竞赛走向限度化落地的必由之路。